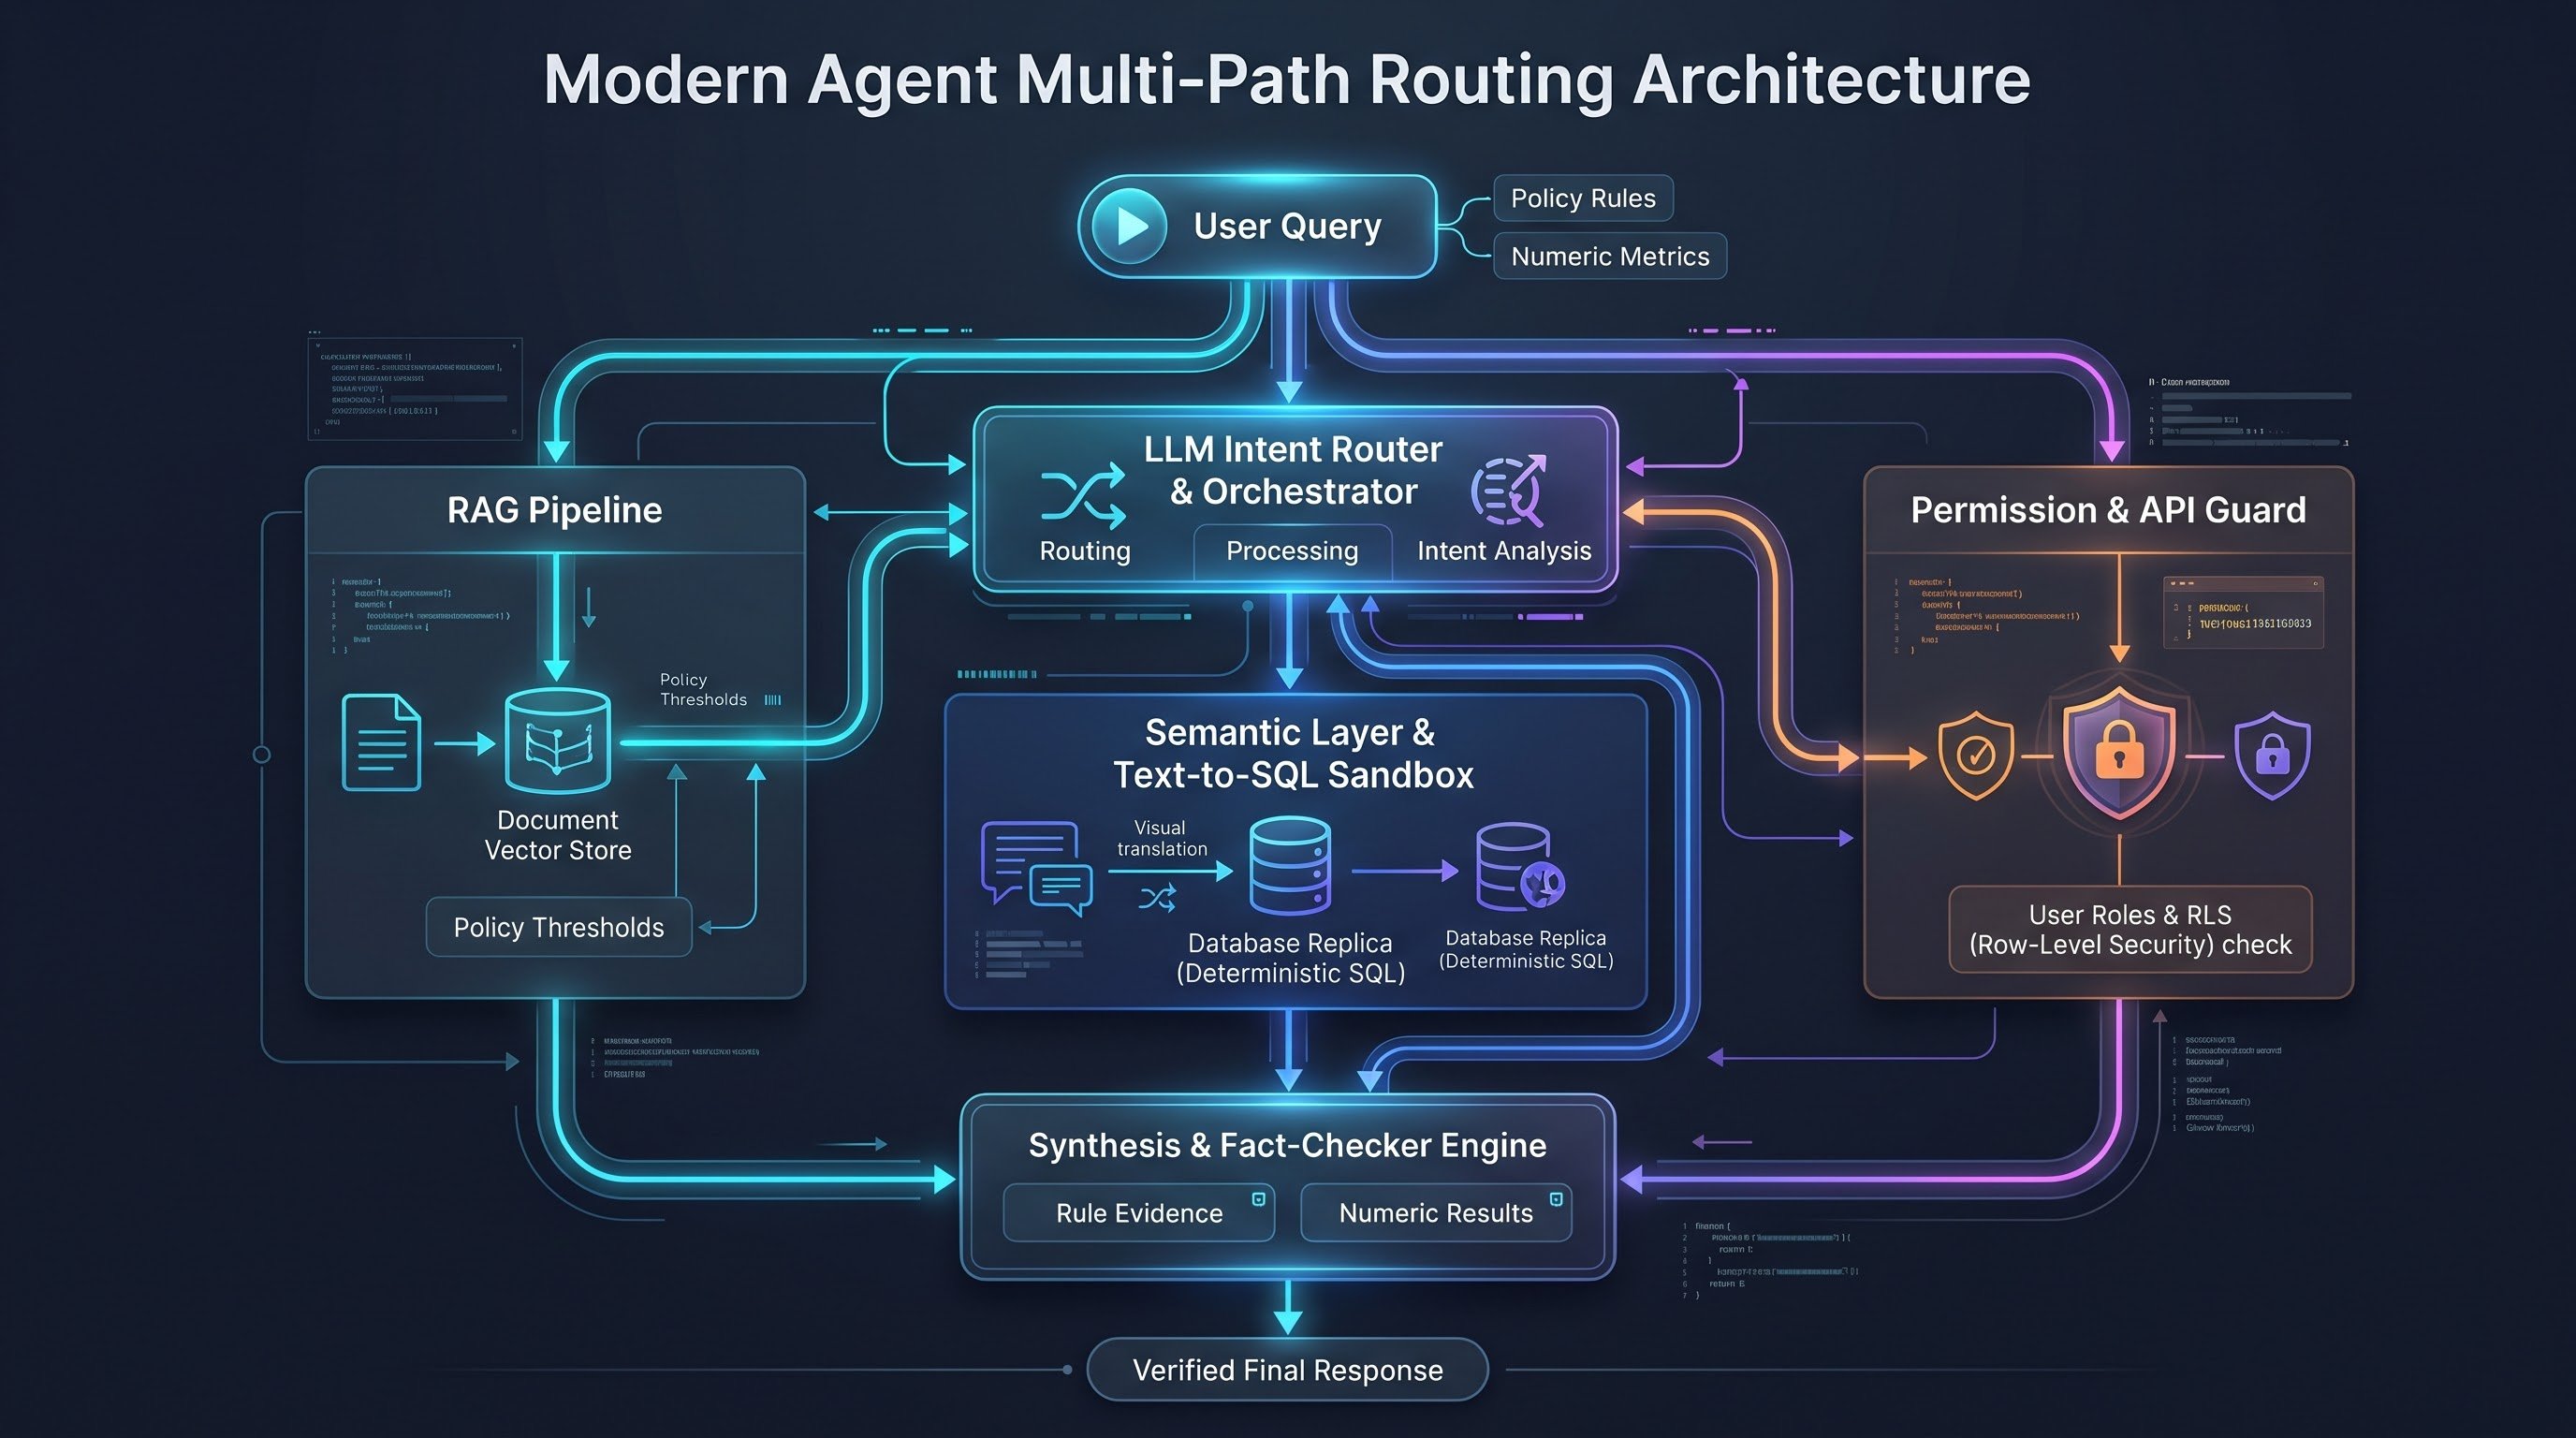
拿着 RAG 的锤子,看什么数据都像钉子
本文同步自 X:原帖
引用讨论:Ethan 恩宇 @UPing123zzz 的实战复盘
做企业知识库和自然语言问答时,很多团队最容易踩的坑,就是「拿着 RAG 的锤子,看什么数据都像钉子」。
看到 Ethan 恩宇 @UPing123zzz 的这篇实战复盘,深有同感。把不同属性的企业数据强行切 Chunk、做 Embedding、塞进向量库,本质上是在最开局就主动抹杀了数据原有的结构。
那面对这种混合数据,像现在的 GPT、先进对话系统和各类 Agent,到底是如何优雅处理的?结合业界成熟方案,可以总结为三个核心机制与架构演进:
1. 现代 Agent 的处理范式:大模型做中枢,确定性交给工具
观察成熟的 Agent(如 ChatGPT 的数据分析模式)会发现:
- 拒绝「心算」:当用户上传 Excel 问「总销售额是多少」时,GPT 绝不是靠 token 预测概率去猜数字,而是现场写一段 Python 代码并在沙箱环境执行,用 Pandas 做确定性计算。
- Tool Use 与意图分发:现代模型最强的是「意图识别与工具编排」。问制度时调用检索插件(RAG),查订单时调用只读数据库 API,查状态时调用业务系统接口。模型始终做「调度员与分析师」,而不是底层计算器。
2. 企业数据的三层分治原则
- 非结构化文档(制度、手册、规范) → RAG / 混合检索:目标是上下文溯源与证据引用,回答必须见原文。
- 结构化业务数据(销售流水、财务对账) → 指标平台 / 确定性查询:严禁用向量相似度去「估算」数字,必须走 SQL、聚合函数与数学逻辑。
- 实时状态与流程(审批流、库存、设备告警) → 业务 API / 专用协议:实时调用,不入库也不做离线索引。
3. Text-to-SQL 落地必须跨过的三道护城河
很多人以为「让模型生成 SQL 就万事大吉」,这是另一个危险误区:
- 语义层(Metrics Layer)解耦:千万别让大模型直连包含几百张复杂缩写表的生产库。必须抽象出一层指标字典与宽表视图,提供规范的 schema 映射。
- 安全沙箱机制:只读从库隔离、强制设置执行超时(Timeout)、硬性限制最大返回条数,敏感字段严格脱敏。
- 行级权限(RLS)注入:将当前提问员工的身份与权限上下文强注入 SQL 生成逻辑,防止越权穿透。
4. 终局架构:意图路由 + 多路协同
企业真实场景往往是交叉的。比如:「按最新差旅标准,华东区上月报销总额是否超标?」
成熟的 Agent 架构会将其拆解为多步工作流:
- 路由分发拆解子任务;
- RAG 从 PDF 制度中提取报销金额上限;
- 调数据库/BI 接口拉取华东区上月实际花销;
- 大模型对比两端返回的客观事实,完成逻辑校验与综合答复。
企业 AI 落地的成熟标志,不是向量数据库跑了多少百万维向量,而是面对不同类型的数据,架构师有没有守住正确的读取与计算范式。