想给桌面机器人接个大脑?我翻了社区三种做法
这两周,开源社区给同一种桌面小机器人接了好几种「脑子」,仓库一个接一个冒出来,名词一个比一个绕。
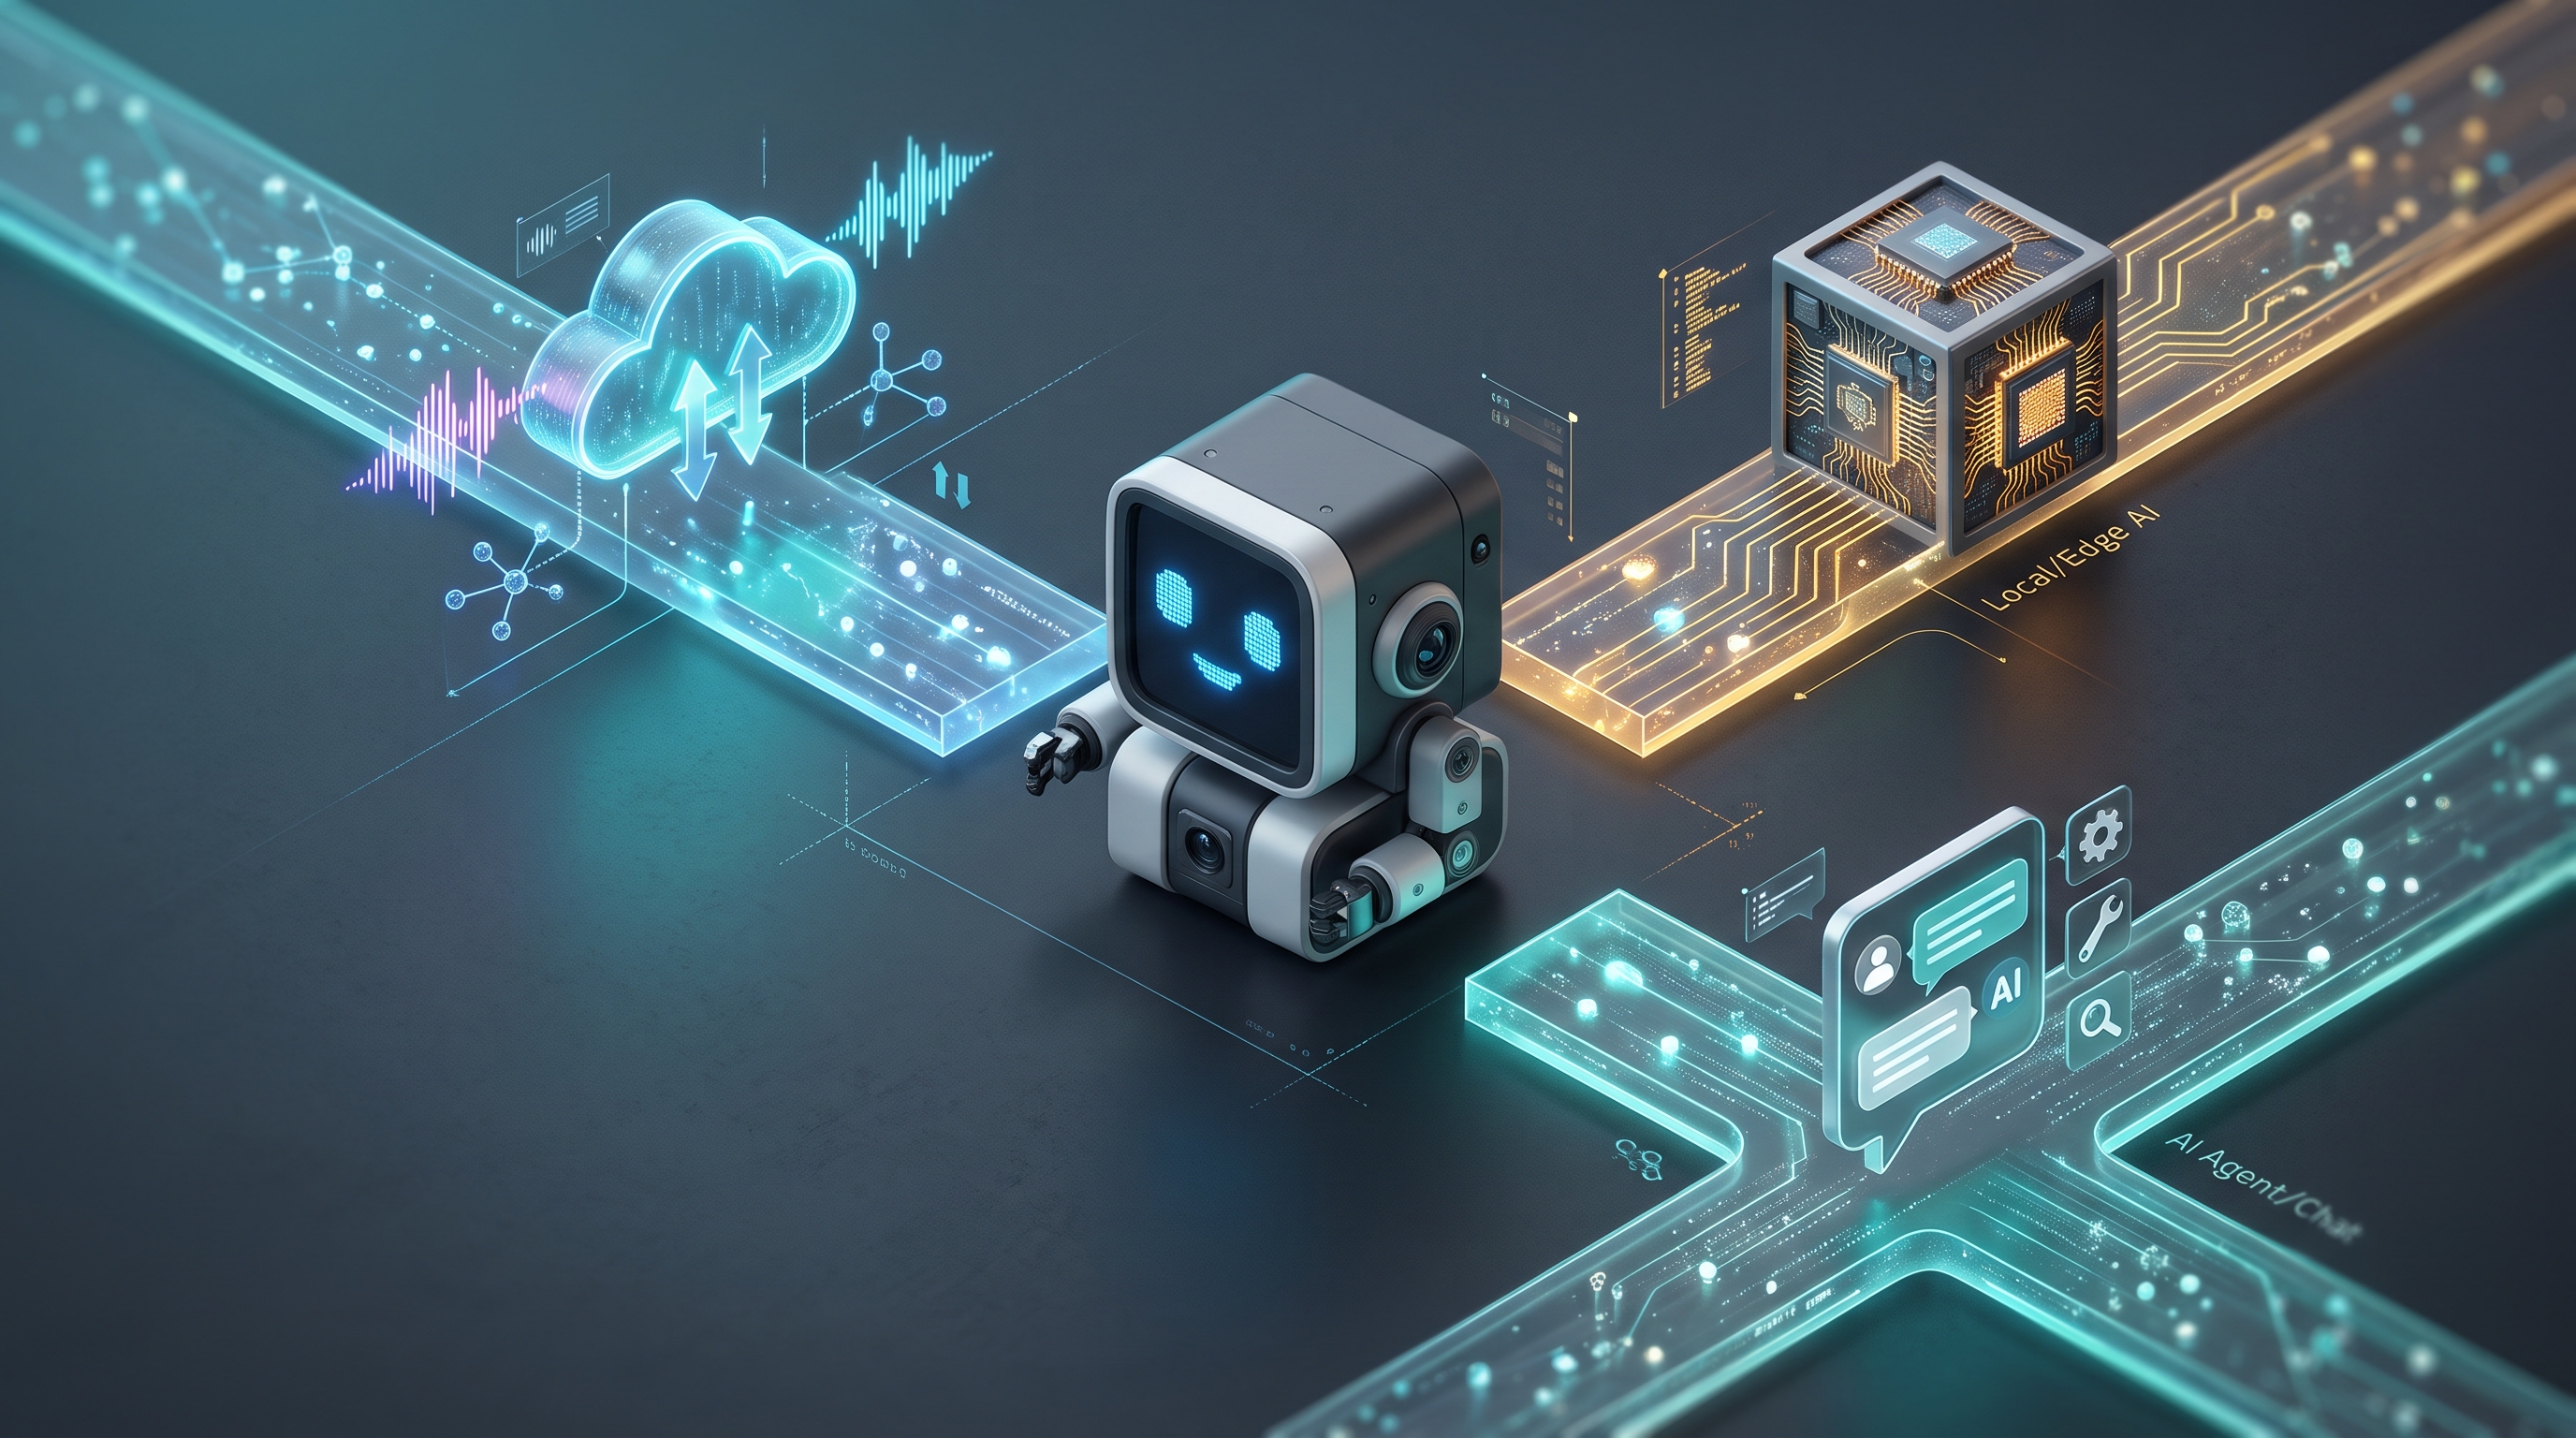
我把它们挨个翻了一遍 README,发现归纳起来其实就三条路:脑子在云端、在你家电脑上,或者干脆借你已经在用的 AI 助手。
免责声明:文中提及的 StackChan 方案与改版我均未上机实测,所有参数、效果与测试结论均摘自作者公开文档。这篇指南旨在帮你理清技术架构,读完能清晰定位适合自己的路线,知道该去哪个仓库读 README。
为什么先看再刷?
1. 先分清板子
后面每条路都绕不开硬件型号: - 普通 CoreS3:一块带屏幕的小方块 ESP32-S3 开发板,没有舵机底座。 - M5StackChan 成品套件:CoreS3 加上带两个串行舵机的运动底座(脖子能灵活转动),带有两排共 12 颗 RGB 氛围灯。小智主线板型中注明其以 K151 出货。注意:M5Stack 官方文档 明确写道,官方 StackChan App 不认普通 CoreS3。 - 其他衍生板:如 CoreS3 SE(无舵机底座精简版)或其他 ESP32 屏幕模块。
2. 刷机风险前置
刷第三方固件存在变砖风险,保修以硬件厂商说明为准。下文每个仓库最多摘录一行官方推荐的构建命令;配网、填服务器地址、填 API 密钥等具体操作请务必严格遵照各仓库 README。动手前第一件事:整片备份!
三路方案全景对照
| 维度 | 第一条路:直接连云 | 第二条路:家里电脑当大脑 | 第三条路:借现成 AI 助手 |
|---|---|---|---|
| 核心机制 | 机器人直连云端实时语音服务 | 刷小智协议固件,本地电脑跑网关与模型 | 机器人充当电脑端 AI 助手的嘴和麦克风 |
| 脑子在哪 | 云端(OpenAI / 豆包 / Muse) | 本机 Docker 容器 + 本地或云端 LLM | 现有桌面端/本地 Agent(Claude / Grok) |
| 常开电脑 | 否(机器人连 Wi-Fi 即可独立运行) | 是(需常开电脑承载识别与中转服务) | 是(网关或 USB 物理连线需持续在线) |
| 硬件门槛 | 普通 CoreS3 / StackChan 成品均有方案 | 主推带舵机的 StackChan 成品 | 视方案而定(声卡方案限成品,像素桌宠限 SE) |
| 核心代价 | 依赖外部网络;按会话时长扣费;缺少回声消除 | 首次搭建费时(Durk 作者估 1-2 小时);需 Docker 与本地算力 | 部分非公开接口存在失效与封号风险 |
第一条路:让它直接连云
这条路线的核心在于去服务器化:机器人配网后直接通过 Wi-Fi 连接第三方实时语音云端服务,家里不需要架设任何常开设备。
1. AI_StackChan_Ex
- 特性与版本:在 v0.25.0 版本引入了 OpenAI 的 GPT-Live 全双工对话;作者在 X 上的发版帖中提到同步支持了 Gemini Live 3.8(提交记录仅注有
Support gemini-3.8-live,未附详尽测试报告)。 - 硬件限制:官方全双工文档明确标明面向 CoreS3 内置音频(原文「CoreS3内蔵音声向け」),构建环境为
m5stack-cores3-realtime,Core2、AtomS3R 及外接音频模块均不适用。舵机控制依赖stackchan-arduino库 v0.0.7 以上,但在成品上的全双工实测情况待核。 - 已知瓶颈:没有集成回声消除(AEC),扬声器声音可能被麦克风重新录入导致自问自答;即使静音也会按会话时长持续扣费(虽然 60 秒无语音会发送结束请求,但不代表计费瞬间截断)。
2. giligili (叽哩叽哩)
- 特性与定位:接入火山引擎豆包实时语音,定位为面向儿童的语音陪伴。
- 硬件限制:README 原文注明「本项目依赖 StackChan 底座外设,不是通用 ESP32 固件」,因此仅适用于 StackChan 成品,普通 CoreS3 无法使用。
- 环境与安全:构建命令为
./build.sh build,安装脚本目前仅支持 macOS Apple Silicon 与 Linux x86_64。安全方面需注意:其 TCP 控制台、蓝牙配网和遥控通道没有应用层身份认证,仅限安全家庭内网使用;建立通话前会查询一次 IP 归属地并写入对话上下文。作者坦白本轮未做真机全功能回归测试。
3. Muse Gadget SDK
- 特性与生态:由 Facebook Incubator 开源,连接 Muse AI 助理。
- 硬件限制:其板型表收录了普通 CoreS3(完整 UI、触屏交互、按电源键说话),构建指令为
tools/muse/board.sh build cores3。但板型表中没有 StackChan,SDK 不接管舵机,刷入成品后头部无法转动。 - 条款与反馈:需配合 Muse 账号与 App 使用,其 SDK Token 条款注明仅限个人非商业用途,原文还写它「not a supported product and not a developer platform」(不是正式支持的产品或开发者平台),存在失效风险。社区反馈分化:有人在 CoreS3 跑通后自述按住按钮才收音且回复仅文字;亦有刷入 StackChan 的玩家写下了失败谈,声音送出后回复却回流到手机端。
小结:此路线免去自建服务器的麻烦,配置最快;代价是语音数据过第三方云端、网络断开即瘫痪,且按时长计费的实时音频消耗不菲。
第二条路:家里电脑当它的大脑
这套方案采用「端-边」协同架构:机器人端刷入兼容小智协议的固件,局域网内的个人电脑或家庭服务器负责跑听、说、想的核心服务,后端模型可自由热插拔。
底座:小智主线 (78/xiaozhi-esp32)
主线在合并了 PR #2337 后,正式引入了 StackChan 成品板型 m5stack/stackchan:
- 构建入口:python ./scripts/build.py m5stack/stackchan
- 适配进度:首期覆盖了屏幕、音频、供电管理与脖子舵机;电容触控、RGB 灯带及闲置摆头功能尚未合并。提交日志中写明:「this reduced configuration has not itself been flashed」(该精简配置合入时未直接经过硬件烧录验证)。最新稳定 Release 仍为 v2.5.2,欲体验需自行编译源码。
- 配套服务:通常配合 xiaozhi-esp32-server 使用,支持 Docker 一键部署或本地运行。
社区三大衍生分支(均面向 StackChan 成品)
-
dotty-stackchan - 固件从官方独立分支维护,本地 Linux 跑 Docker 服务端,语音识别与合成均在局域网内处理。 - 大脑默认运行本地
pi编程 Agent 加小模型,兼容 Ollama 与 OpenAI 格式接口。 - 固件为纯源码交付(Source-only: the server address is compiled in),服务器 IP 需硬编码入固件重新编译。视觉模块默认会将画面上传至云端;内置的儿童过滤被作者称为「a weak, bypassable backstop」(脆弱且易绕过的初级兜底)。最新 fw-v1.3.5 修复了 I2C 通信异常导致整机重启的问题,仅作了冒烟测试。 -
Durk for Stack-chan - 组合方案:固件改自 xiaozhi-esp32 v2.5.2,服务端改自 v0.9.7,大脑与音色采用 xAI 的 Grok(需按量计费)。 - 根据其 SETUP 指南,需一台常开电脑(支持 Win/Mac/Linux)并下载本地语音模型,首次配置耗时约 1-2 小时。 - 优势在于配网页面直接提供服务器地址输入框,修改无需重编译固件。提供常规与「unhinged」两种对话模式,免费版提供固件与教程,作者亦提供付费预置配置包。
-
Nous-Girl - 板型标为
M5Stack StackChan K151 (CoreS3),Docker 运行小智服务端负责流媒体交互。 - 大脑可选接 Nous Research 的 Hermes Agent(具备长效记忆与工具调用),亦可接入本地 Ollama。 - 公开固件不内置服务器 IP,方便烧录;目前服务端仅在 Apple Silicon Mac 上通过测试,作者提醒固件仍处于 Beta 阶段。注意:原作者初始推文仓库链接有误,请认准dax8it/nous-girl-stackchan官方主仓。
小结:隐私度高、大模型选择完全自由;但首次配置门槛高,依赖家中电脑 24 小时待命,且多由独立开发者单机验证,容错率较低。
第三条路:借你现成的 AI 助手
不重构复杂链路,直接让机器人变身为日常已经在用的 AI 助手的「实体外设」。
1. xiaozhi-hub-server
- 免刷机特性:无需重刷固件,直接将出厂固件的 OTA 地址指向该中转网关,即可通过语音唤醒将任务分发给本机 AI(例如本地运行的 Claude Code)。
- 实测与边界:作者实测基于 StackChan 官方固件 1.5.1;官方小智固件 1.6.1+ 亦可使用,但未明确包含普通 CoreS3。务必警惕网关端口不要裸露到公网。后续加入的 Grok Bot 模块使用的是逆向非官方接口,存在账号风控隐患。
2. stackchan-mcp
- Agent 控制流:构建 MCP(Model Context Protocol)网关,允许外部智能体直接通过标准协议调取机器人的发音、监听与转头控制接口。固件基于上游 xiaozhi-esp32 v2.2.6 定制,专用于官方成品套件。
3. stackchan-desk-voice
- 极简物理声卡模式:机器人通过 USB-C 直连电脑,降级为一个带触摸感应的 USB 麦克风与扬声器。
- 双击头部两次,电脑端脚本自动唤醒 Grok 桌面 App 的实时通话,全程一根 USB-C 线,不碰账号接口。缺点是脚本仅支持 Windows 环境,无回声消除,且仅适用于成品。
4. 屏幕衍生玩法:clawd-pet
- 适合只有 CoreS3 SE(无底座)的用户:将 Claude Code 的执行状态实时投射至屏幕,呈现一只随指令思考、敲代码与待机的像素小螃蟹,属于低成本趣味桌面小摆件。
怎么选?几个避坑提醒
决策三问法
- 看硬件:手里是普通 CoreS3 还是 StackChan 成品?普通板优先看 AI_StackChan_Ex 或 Muse;成品底座方案请直接看小智或声卡方案。
- 看环境:是否接受家里常开一台电脑?不接受选连云路线;接受可选本地大脑或 MCP。
- 看成本:是愿意按用量向云端付 API 费用,还是用自己的电脑显卡拼算力,亦或是复用现有的订阅制助手?
有玩家长期体验后评价:它「可玩性很高,实用性不大」,拾音要凑近说,模型回复又慢,更适合当单向推送信息的展示设备。这是他的个人体验,帖子里没有测量数据。
社区高频硬件踩坑指南
- 舵机供电坑(小智主线): 底座舵机电源由扩展芯片的第 0 引脚控制,系统上电默认处于关闭状态。若固件未显式拉高该引脚,总线依然可以读取角度数据,但舵机完全无法通电转动。作者在 PR 里说,为了找这个问题花了十个固件版本。
- 屏幕驱动批次变更: 根据 CoreS3 官方产品页 记录,官方自 2026 年 8 月 7 日起将屏幕驱动 IC 从 ILI9342C 变更为 ILI9342E;而小智 StackChan 板型的 README 写的还是 ILI9342C。新批次机器上显示是否正常,我没找到证据,待核。
- 缺少回声消除(AEC): 多数直连云方案未做声学回声抵消,扬声器播放时麦克风会自发录入,形成死循环自问自答,同时由于静音期间保持推流,可能带来意外的扣费。
- 出厂 NVS 零点校准保护: stackchan-desk-voice 的 README 反复强调:成品出厂 NVS 里存着舵机零点校准,刷机前先整片备份 16MB Flash、只写应用区、不要全片擦除;但 Durk 的首次完整刷写步骤里却带全片擦除。两边写法不一样,照你选的仓库来,备份这一步别省。
- 非官方逆向 API 封号风险: 走非公开接口的项目(如 xiaozhi-hub-server 的 Grok Bot 通道),App 一升级就可能断,也可能违反服务条款、有账号风险,我不推荐。
动手前自检清单
- [ ] 确认手中硬件确切型号(普通板 vs 成品底座 K151)
- [ ] 完整备份 16MB Flash 原始固件(保留舵机零点校准)
- [ ] 确认目标仓库为原版主仓,拒绝镜像与未经验证的 Copy
- [ ] 评估云端语音扣费规则与网络环境延迟
- [ ] 尽量选用带标准 API 或本地 MCP 协议的安全方案